Domain elearning-system.de kaufen?
Wir ziehen mit dem Projekt
elearning-system.de um.
Sind Sie am Kauf der Domain
elearning-system.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain elearning-system.de kaufen?
Kennt ihr ein gutes Open-Source-Text-to-Speech (TTS)-Modell?
Ja, ein bekanntes Open-Source-Text-to-Speech-Modell ist Tacotron. Es wurde von Google entwickelt und ist in der Lage, natürliche Sprache zu generieren. Tacotron ist in Python implementiert und kann für verschiedene Anwendungen verwendet werden, wie z.B. Sprachassistenten oder Hörbücher. **
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **

Ähnliche Suchbegriffe für Text-to-Speech TTS
Top-Angebote
Produkte zum Begriff Text-to-Speech TTS:
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Deep Learning for NLP and Speech Recognition, Fachbücher von Uday KamathDas Fachbuch "Deep Learning for NLP and Speech Recognition" bietet eine umfassende Einführung in die Architektur des Deep Learning und deren Anwendungen in verschiedenen Aufgaben der natürlichen Sprachverarbeitung sowie der Spracherkennung. Es adressiert die wachsende Nachfrage nach einem einheitlichen Nachschlagewerk, das die Techniken des Deep Learning mit praktischen Anwendungen in Bereichen wie Finanzen, Gesundheitswesen und Regierung verknüpft. Das Buch behandelt aktuelle Methoden des Deep Learning, die für NLP und Sprachanwendungen relevant sind, und bietet einen Überblick über moderne Ansätze sowie reale Fallstudien, die mit Codebeispielen ergänzt werden, um praktische Erfahrungen zu ermöglichen. Die Struktur des Buches ist in drei Teile gegliedert, die auf unterschiedliche Zielgruppen und deren Fachkenntnisse abgestimmt sind, und bietet somit sowohl Einsteigern als auch erfahrenen Fachleuten wertvolle Einblicke.74,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
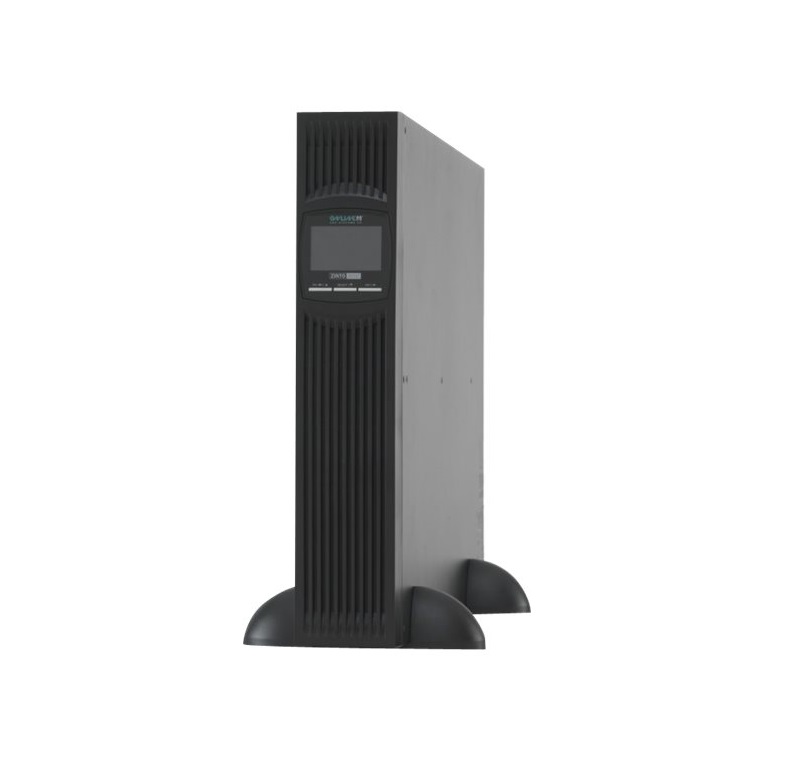
ONLINE USV XANTO 6000 Online (X6000)Produktbeschreibung: Online USV XANTO 6000 - USV - 6000 Watt - 6000 VA, Gerätetyp: USV - in Rack montierbar/extern, Rack-Größe: 48,3 cm (19") - 2U, Gewicht: 17 kg, Eingangsspannung: Wechselstrom 230 V, Ausgangsspannung: Wechselstrom 208/220/230/240 V ± 1%, Leistungskapazität: 6000 Watt / 6000 VA, Redundante Stromversorgung: Optional, Eingangsanschlüsse: Klemmleiste, Ausgabeanschlussstellen: Klemmleiste, Batterie: Bleisäure - 7 Ah, Anz. Batterien: 16, Netzwerk: RS-232, USB, Zubehör im Lieferumfang: Vertikales Gestell, Abmessungen (Breite x Tiefe x Höhe): 43,8 cm x 61 cm x 8,8 cm2393,39 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
Top-Angebote
Produkte zum Begriff Text-to-Speech TTS:
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kennt ihr ein gutes Open-Source-Text-to-Speech (TTS)-Modell?
Ja, ein bekanntes Open-Source-Text-to-Speech-Modell ist Tacotron. Es wurde von Google entwickelt und ist in der Lage, natürliche Sprache zu generieren. Tacotron ist in Python implementiert und kann für verschiedene Anwendungen verwendet werden, wie z.B. Sprachassistenten oder Hörbücher. **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
Ähnliche Suchbegriffe für Text-to-Speech TTS
-
Deep Learning for NLP and Speech Recognition, Fachbücher von Uday KamathDas Fachbuch "Deep Learning for NLP and Speech Recognition" bietet eine umfassende Einführung in die Architektur des Deep Learning und deren Anwendungen in verschiedenen Aufgaben der natürlichen Sprachverarbeitung sowie der Spracherkennung. Es adressiert die wachsende Nachfrage nach einem einheitlichen Nachschlagewerk, das die Techniken des Deep Learning mit praktischen Anwendungen in Bereichen wie Finanzen, Gesundheitswesen und Regierung verknüpft. Das Buch behandelt aktuelle Methoden des Deep Learning, die für NLP und Sprachanwendungen relevant sind, und bietet einen Überblick über moderne Ansätze sowie reale Fallstudien, die mit Codebeispielen ergänzt werden, um praktische Erfahrungen zu ermöglichen. Die Struktur des Buches ist in drei Teile gegliedert, die auf unterschiedliche Zielgruppen und deren Fachkenntnisse abgestimmt sind, und bietet somit sowohl Einsteigern als auch erfahrenen Fachleuten wertvolle Einblicke.74,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
ONLINE USV XANTO 6000 Online (X6000)Produktbeschreibung: Online USV XANTO 6000 - USV - 6000 Watt - 6000 VA, Gerätetyp: USV - in Rack montierbar/extern, Rack-Größe: 48,3 cm (19") - 2U, Gewicht: 17 kg, Eingangsspannung: Wechselstrom 230 V, Ausgangsspannung: Wechselstrom 208/220/230/240 V ± 1%, Leistungskapazität: 6000 Watt / 6000 VA, Redundante Stromversorgung: Optional, Eingangsanschlüsse: Klemmleiste, Ausgabeanschlussstellen: Klemmleiste, Batterie: Bleisäure - 7 Ah, Anz. Batterien: 16, Netzwerk: RS-232, USB, Zubehör im Lieferumfang: Vertikales Gestell, Abmessungen (Breite x Tiefe x Höhe): 43,8 cm x 61 cm x 8,8 cm2393,39 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
ONLINE USV ZINTO 3000 Online (Z3000)Produktbeschreibung: Online USV ZINTO A 3000 - USV - 2700 Watt - 3000 VA, Gerätetyp: USV - in Rack montierbar/extern, Rack-Größe: 2U, Gewicht: 29,3 kg, Eingangsspannung: Wechselstrom 230 V, Ausgangsspannung: Wechselstrom 208/220/230/240 V ± 3%, Leistungskapazität: 2700 Watt / 3000 VA, Eingangsanschlüsse: 1 x Strom IEC 60320 C20, Ausgabeanschlussstellen: 8 x power IEC 60320 C13 1 x Strom IEC 60320 C19, Anz. Batterien: 6 (installiert) / 6 (unterstützt), Netzwerk: RS-232, USB, Zubehör im Lieferumfang: Vertikales Gestell, Abmessungen (Breite x Tiefe x Höhe): 8,8 cm x 63,2 cm x 43,8 cm1228,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
ONLINE USV XANTO 3000 Online (X3000)Produktbeschreibung: Online USV XANTO 3000 - USV - 3000 Watt - 3000 VA, Gerätetyp: USV - extern, Gewicht: 28,5 kg, Eingangsspannung: Wechselstrom 230 V, Ausgangsspannung: Wechselstrom 208/220/230/240 V ± 1%, Leistungskapazität: 3000 Watt / 3000 VA, Eingangsanschlüsse: 1 x Strom IEC 60320 C20, Ausgabeanschlussstellen: 9 x power IEC 60320 C13 1 x Strom IEC 60320 C19, Batterie: Bleisäure - 9 Ah, Anz. Batterien: 6, Betriebszeit (bis zu): 6 Min. bei voller Last, Netzwerk: RS-232, USB, Abmessungen (Breite x Tiefe x Höhe): 19 cm x 41,5 cm x 33,5 cm1685,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.